Wenn wir „KI“ sagen, meinen wir fast immer dasselbe
Künstliche Intelligenz | Themen & Trends
Diese Sorge ist berechtigt. Aber sie beruht auf einer Annahme, die nicht immer stimmt: dass KI zwangsläufig Inhalte lesen und verstehen muss, um nützlich zu sein. Das ist nicht so. Es gibt KI, die überhaupt keine Texte liest und trotzdem täglich Zeit spart. Ein Beispiel dafür haben wir bei Westernacher Solutions gebaut, und genau darum geht es in diesem Beitrag.
Das alltägliche Problem: sortieren, bevor die eigentliche Arbeit beginnt
Behörden, Gerichte und kirchliche Verwaltungen erhalten jeden Tag große Mengen an Dokumenten: Anträge, Ausweiskopien, Bescheinigungen, Nachweise. Bevor jemand sie inhaltlich prüfen kann, müssen diese Unterlagen erst einmal sortiert werden.
Das klingt banal, ist es in der Praxis aber selten. Denn wer Unterlagen einreicht, hält sich nicht immer an Vorgaben: Ein Etikett fehlt, eine Kennzeichnung wird vergessen, eine Seite ist falsch benannt. Die Folge: Dokumente landen ohne klare Zuordnung auf den Schreibtischen und müssen von Hand einsortiert werden, bevor überhaupt die fachliche Arbeit beginnt. Das kostet Zeit, verzögert Prozesse und bindet Personal, das eigentlich für die inhaltliche Prüfung gebraucht wird.
Der naheliegende Reflex: Warum er im öffentlichen Sektor riskant ist
Der offensichtliche Gedanke lautet: „Dann soll doch eine KI die Dokumente lesen und automatisch einsortieren.“ Genau hier beginnt jedoch das Problem, das viele Organisationen mit hohen Datenschutzanforderungen zurückschrecken lässt.
Eine KI, die den Inhalt von Dokumenten liest, bringt drei typische Risiken mit:
- Sensible Trainingsdaten: Sie benötigt in der Regel echte, personenbezogene Daten wie Namen, Adressen, Geburtsdaten und Ausweisnummern.
- Verarbeitung im Betrieb: Auch im laufenden Einsatz verarbeitet sie diese sensiblen Inhalte fortlaufend.
- Verzerrte Ergebnisse: Sie kann Fehler machen, die sich systematisch gegen bestimmte Gruppen richten, etwa bei ungewöhnlichen Namen oder Sonderzeichen.
Für Organisationen, die auf Datenschutz, Rechtssicherheit und Fairness besonders achten müssen, ist das keine gute Ausgangslage. Und genau an diesem Punkt lohnt es sich, die eingangs beschriebene Annahme zu hinterfragen: Muss die KI die Dokumente überhaupt lesen?
Die Lösung: KI, die Dokumente an ihrer Form erkennt, nicht an ihrem Inhalt
Wir haben einen anderen Weg gewählt, und das ist der Kern dieses Beitrags: Unsere KI liest die Dokumente gar nicht. Sie schaut sich stattdessen an, wie ein Dokument aussieht.
Ein Bild aus dem Alltag hilft zum Verständnis: Wenn Sie über den Schreibtisch einer Kollegin gehen und dort einen Stapel Papier sehen, erkennen Sie auf einen Blick, um welche Dokumente es sich handelt. Ein Ausweis sieht anders aus als ein Formular, ein Formular anders als eine Bescheinigung. Dafür müssen Sie kein einziges Wort lesen. Form, Layout und Struktur reichen aus.
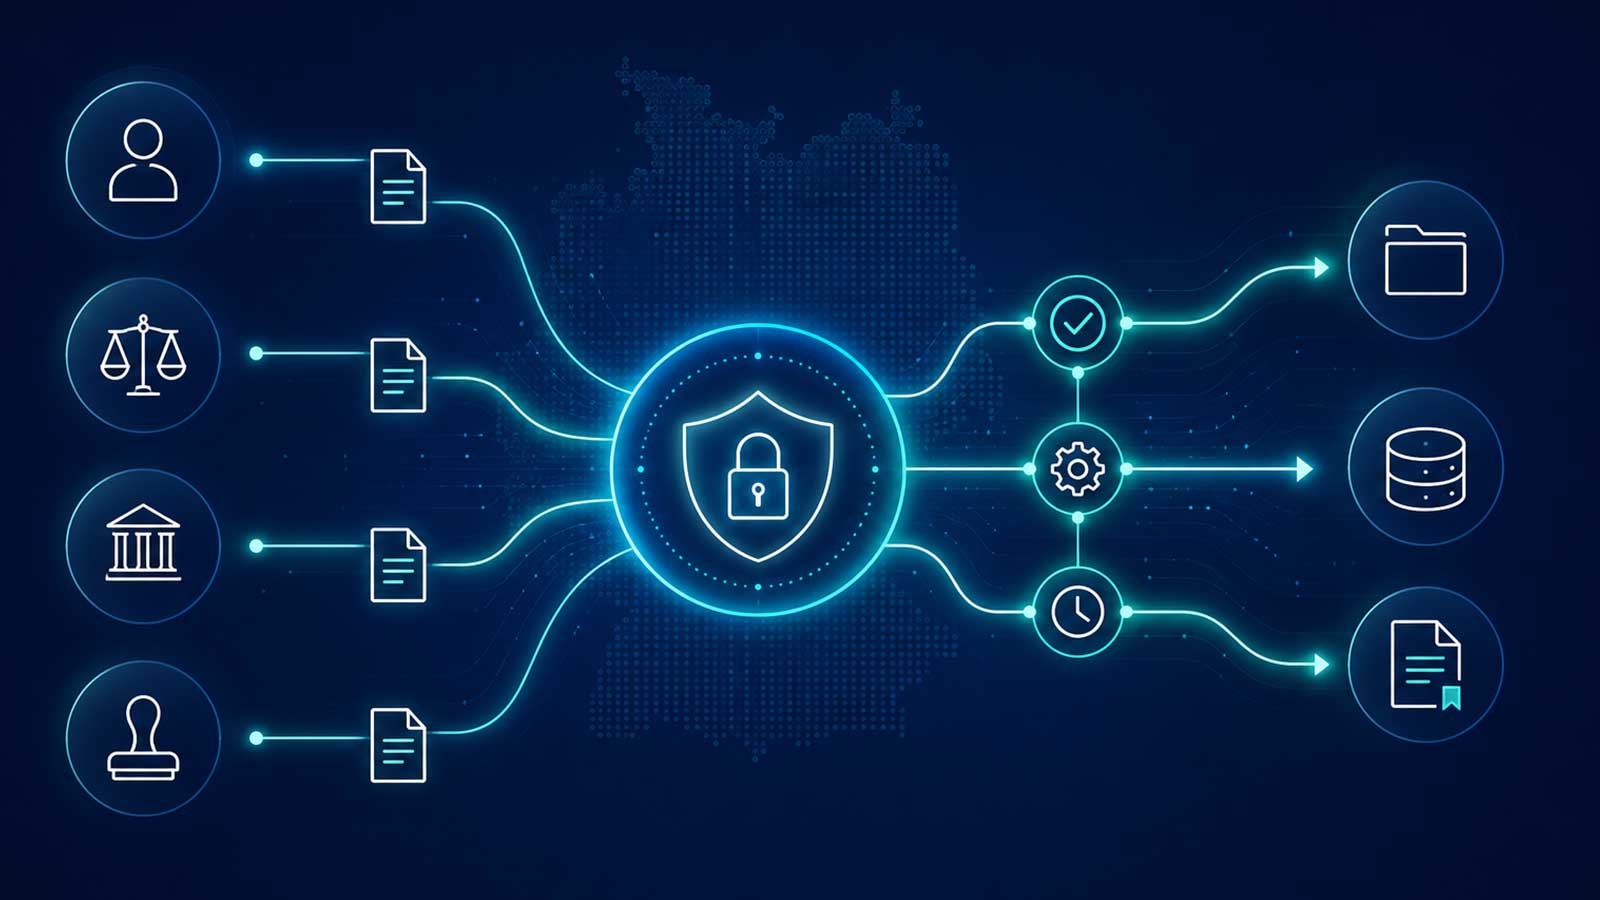
Genau so arbeitet unsere Lösung. Das Dokument wird zunächst in ein Schwarz-Weiß-Bild umgewandelt. Anschließend erkennt die KI über Kontraste, welche Bereiche für die Form des Dokuments wichtig sind: Rahmen, Felder, Linien, Stempel, Unterschriftsbereiche oder typische Dokumentabschnitte. Diese Bereiche markiert sie im Bild mit Boxen. So wird nachvollziehbar, woran die KI die Dokumentart festmacht: nicht an Namen oder Adressen, sondern an sichtbaren Strukturen.
Das Ergebnis: Unterlagen werden automatisch der richtigen Kategorie zugeordnet, ohne dass die KI je erfährt, um welche Person es geht oder welche Daten das Dokument enthält. Die Mitarbeitenden erhalten die Zuordnung als Vorschlag und bestätigen oder korrigieren sie mit einem Klick. Die Entscheidung bleibt immer beim Menschen.

KI-gestützte Dokumentenklassifizierung anhand visueller Strukturen – ohne Inhalte auszulesen.
Warum das mehr ist als ein technisches Detail
Dass diese KI kein großes Sprachmodell ist, ist kein Nebenaspekt, sondern der eigentliche Vorteil. Denn daraus ergeben sich unmittelbar konkrete Vorteile für Ihre Organisation:
- Weniger Datenschutzaufwand: Was nicht gelesen wird, muss auch nicht geschützt, dokumentiert oder rechtlich abgesichert werden. Personenbezogene Inhalte spielen für die Klassifizierung schlicht keine Rolle.
- Volle Kontrolle im eigenen Haus: Die Lösung läuft lokal in Ihrer IT-Umgebung. Es verlassen keine Daten das Haus. Das ist ein zentraler Baustein digitaler Souveränität.
- Weniger Verzerrung: Wer keine Namen liest, kann auch nicht bei ungewöhnlichen Namen ins Straucheln geraten. Die Klassifizierung nach Form ist fairer, weil sie die Person gar nicht kennt.
- Schnellere Prozesse: Weniger manuelle Sortierarbeit bedeutet mehr Zeit für die eigentliche fachliche Prüfung.
Nicht die Größe ist entscheidend, sondern das Problem
Dieser Anwendungsfall ist kein Zufallsprodukt. Er zeigt, wie wir bei Westernacher Solutions arbeiten. Wir laufen bewusst keinem Hype hinterher. Nur weil große Sprachmodelle gerade das Bild von KI bestimmen, heißt das nicht, dass sie für jede Aufgabe die richtige Wahl sind. Für uns steht nicht die Technologie am Anfang, sondern das Problem: Was genau soll gelöst werden, und welche Lösung passt dazu, ohne mehr Daten zu berühren als nötig?
Genau deshalb haben wir uns in diesem Fall gegen die naheliegende, „große“ Lösung entschieden und für eine, die zum Anwendungsfall passt und dabei personenbezogene Daten schützt. Nicht die größte KI hat gewonnen, sondern die passende.
Solche Lösungen bauen wir nicht am Kunden vorbei. Der wichtigste Teil unserer Arbeit passiert im Gespräch: Wir setzen uns mit den Menschen zusammen, die täglich mit den Prozessen arbeiten, verstehen ihren konkreten Use Case und entwickeln daraus eine Lösung, die wirklich zu ihrer Organisation passt: technisch, rechtlich und im Arbeitsalltag. Denn eine KI, die an der Realität der Anwenderinnen und Anwender vorbei entwickelt wird, hilft niemandem.
Für den öffentlichen Sektor ist dieser Ansatz besonders wichtig. Behörden, Gerichte und kirchliche Verwaltungen tragen eine hohe Verantwortung für die Daten, die ihnen anvertraut werden. Sie brauchen keine Technologie, die möglichst viel kann, sondern Lösungen, die genau das Richtige tun: nachvollziehbar, datensparsam und unter ihrer eigenen Kontrolle.
Die entscheidende Frage lautet für uns deshalb nie „Welche KI ist die größte?“, sondern: „Welche KI passt zu diesem Problem, und wer behält dabei die Kontrolle über die Daten?“ Diese Frage stellen wir gemeinsam mit unseren Kunden. Und wir bauen die Lösung, die daraus entsteht.
Fazit: Die passende KI folgt dem Problem, nicht dem Hype
Die Erkenntnis aus diesem Anwendungsfall ist zugleich die einfachste: KI muss nicht groß, allwissend und textlesend sein, um zu helfen. Manchmal ist die bessere Lösung die, die bewusst weniger tut und dafür genau das Richtige.
Für den öffentlichen Sektor ist das eine wichtige Botschaft. Nicht jede Aufgabe braucht ein großes Sprachmodell mit all seinen Datenschutz- und Kontrollfragen. Wer ein klar umrissenes Problem lösen will, etwa das Sortieren von Dokumenten, ist mit einer spezialisierten, souveränen KI oft besser, sicherer und nachvollziehbarer beraten.
Westernacher Solutions begleitet öffentliche Organisationen bei genau diesen Abwägungen. Der Ansatz ist nicht technologiegetrieben, sondern verantwortungsorientiert. Denn die entscheidende Frage lautet nie „Welche KI ist die größte?“, sondern: „Welche KI passt zu unserem Problem, und wer kontrolliert dabei die Daten?“
Häufige Fragen zur Dokumentenklassifizierung ohne Texterkennung

Ihre Ansprechpartnerin
Dr. Maria Börner
AI Competence Center Lead
AUCH INTERESSANT